GPT-5.6 modelkeuze: Sol, Terra, Luna, effort en pro mode
API-configuratie · 9 juli 2026
GPT-5.6 kies je op drie losse assen: de modeltier bepaalt de capaciteits- en kostenklasse, reasoning effort bepaalt hoeveel redeneerwerk je vraagt en pro mode bepaalt of het model extra werk mag doen voor één quality-first antwoord.
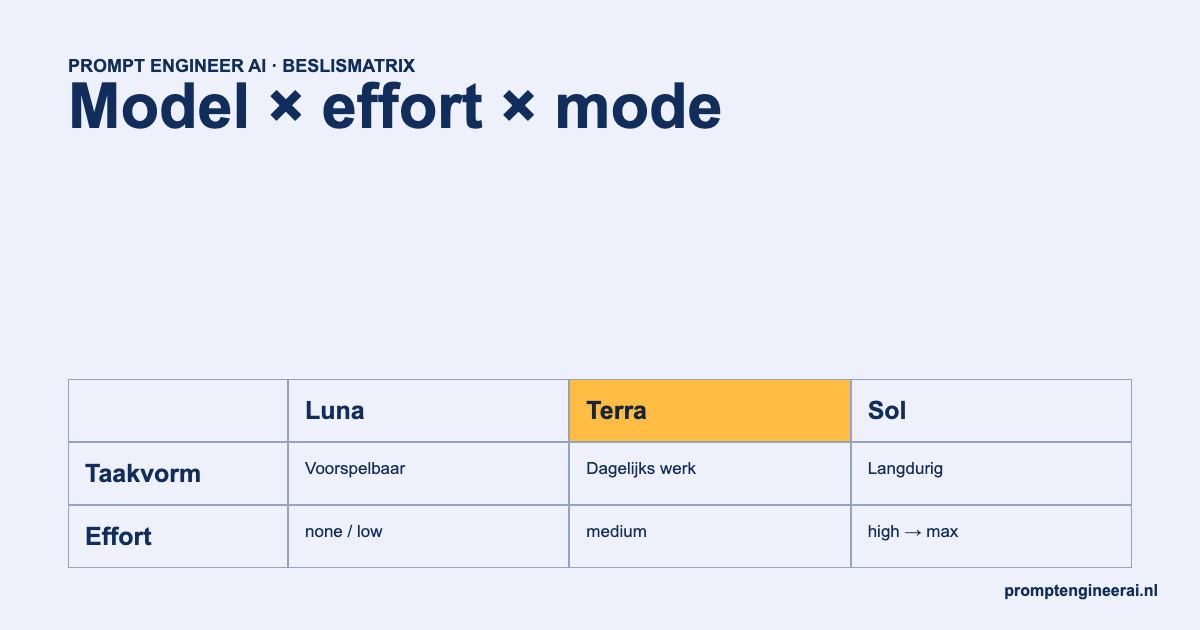
As 1: kies de tier op taakvorm
Luna past bij voorspelbare bulk met een vast schema. Terra is de productie-default voor dagelijks kenniswerk. Sol is bedoeld voor complexe code en agenttaken die langer doorlopen, meerdere tools combineren en na tussenresultaten zelf moeten bijsturen. De alias gpt-5.6 routeert volgens OpenAI naar gpt-5.6-sol.
As 2: stel effort bewust in
Gebruik medium als baseline en low voor latencygevoelige workloads. High en xhigh zijn zinvol als extra redenering aantoonbaar meer taaksucces geeft. Reserveer max voor de moeilijkste quality-first taken en vergelijk het altijd met xhigh; de hoogste instelling is niet automatisch de beste verhouding.
As 3: pro mode is geen modelslug
Pro mode wordt in de Responses API gezet met reasoning.mode: "pro" op de gekozen tier. Het kan betrouwbaarheid bij moeilijke taken verhogen, maar kost meer latency en modelwerk. Test dezelfde taak in standaard- en pro mode met dezelfde tier en effort.
Robuuste baselinemodel: gpt-5.6-terrareasoning.effort: medium
Ga alleen naar Luna, Sol of pro mode na een vergelijkende evaluatie.
Wanneer Programmatic Tool Calling past
Bewaar de routebeslissing in telemetry
Log minimaal modeltier, effort, mode, taaktype, evaluatieversie en escalatiereden. Voeg geen gevoelige promptinhoud toe als dat niet nodig is. Met deze velden kun je later zien of Sol vooral rework voorkomt, Luna werkelijk op schaal goedkoper is en pro mode op welke taakklasse een meetbare winst geeft. Zonder routeringsdata blijft optimalisatie beperkt tot globale factuur- en latencycijfers.
Migreren zonder schijnwinst
Vergelijk taakresultaat, volledigheid, vereist bewijs, totale tokens, latency en kosten. Minder calls of kortere output is alleen winst als het zichtbare eindresultaat nog alle acceptatiecriteria haalt. Pin tijdens de vergelijking een modelsnapshot waar dat kan, bewaar de prompt- en toolversie en verander één configuratie-as tegelijk. Anders weet je na een verbetering niet of tier, effort, mode of context de oorzaak was.
Haal effort, Fast en Ultra uit elkaar
Drie bedieningselementen lijken op elkaar, maar sturen iets anders. Effort bepaalt hoeveel redeneerruimte één model krijgt. Fast versnelt een ondersteund model tegen een hoger credittarief. Ultra start standaard vier agents naast elkaar. Wie alles als “meer denkkracht” behandelt, kan een kleine taak onnodig duur maken.
| Knop | Wat verandert? | Goede reden om hem te gebruiken |
|---|---|---|
| Medium / high / max | Reasoning effort van het gekozen model | Je eigen taakset laat minder herstelwerk zien bij een hoger niveau. |
| Fast | Hogere snelheid en hoger creditverbruik | Wachttijd kost meer dan de extra credits en het model wordt officieel ondersteund. |
| Ultra | Vier agents parallel als standaard | De opdracht heeft echt onafhankelijke werkstromen die tegelijk kunnen lopen. |
De Codex Speed-pagina noemt op 12 juli 2026 alleen GPT-5.5 en GPT-5.4 voor Fast. De genoemde multipliers gelden daarom niet automatisch voor GPT-5.6. Ultra is wél officieel onderdeel van GPT-5.6; OpenAI zegt er expliciet bij dat de modus meer tokens gebruikt.
Leg naast model en effort ook taaksucces per credit vast: geslaagde eindchecks, herstelrondes, doorlooptijd en totale credits. Alleen dan zie je of een zwaardere instelling echt goedkoper uitpakt dan een mislukte lichte run.
Broncontrole 12 juli 2026: GPT-5.6 launchinformatie, Codex Speed en de Codex rate card.
Bronnen en claimgrenzen
Deze pagina is gecontroleerd aan de hand van de officiële OpenAI-modelgids voor GPT-5.6 en de aankondiging van OpenAI Developers van 9 juli 2026. OpenAI positioneert Sol, Terra en Luna voor verschillende taakvormen. Prestaties, latency en kosten blijven workload-afhankelijk; test daarom met eigen representatieve taken. De modelnamen gaan over de API en zeggen niet automatisch welke modellen in ieder ChatGPT-abonnement zichtbaar zijn.
Modelkeuze is ook contextkeuze
Sol kiezen voor een lastige taak is logisch. Dezelfde taak honderdduizenden tokens laten meeslepen is dat vaak niet. GPT-5.6 Sol schakelt boven 272.000 inputtokens naar een long-contexttarief: $10 per miljoen inputtokens, $1 voor cached input en $45 per miljoen outputtokens. OpenAI rekent dat voor het volledige verzoek.
Codex ondersteunt een automatische compactiegrens in ~/.codex/config.toml:
model_context_window = 272000
model_auto_compact_token_limit = 240000
Zie 240K als werkbuffer, niet als magisch optimum. Een prompt-engineeringtaak met grote MCP-beschrijvingen of logs kan eerder compactie nodig hebben. Een taak met subtiele ontwerpbesluiten kan juist kwaliteit verliezen als de samenvatting een nuance overslaat.
Test de samenvatting, niet alleen de instelling
- Laat Codex na compactie het doel en de non-goals herhalen.
- Controleer of exacte bestandsnamen, tests en stopregels behouden zijn.
- Start een nieuwe taak als onderzoek en implementatie verschillende context nodig hebben.
De instelling verlaagt geen tokenprijs en maakt korte gesprekken niet goedkoper. De dollarprijzen gelden voor de API, niet automatisch voor je Codex-abonnement.
Broncontrole 12 juli 2026: OpenAI GPT-5.6 Sol en de Codex-configuratiereferentie. De dollarbedragen zijn API-prijzen; Codex-abonnementen kunnen met credits of gebruikslimieten werken.